Ложные активации голосовых ассистентов: что показывают тесты в шуме
Ложное срабатывание голосового ассистента — это не только реакция на громкий телевизор или случайный шум. Детектор может принять за ключевую фразу обычную речь, точное совпадение из медиаконтента или сочетание звуков, которое лишь частично похоже на команду.
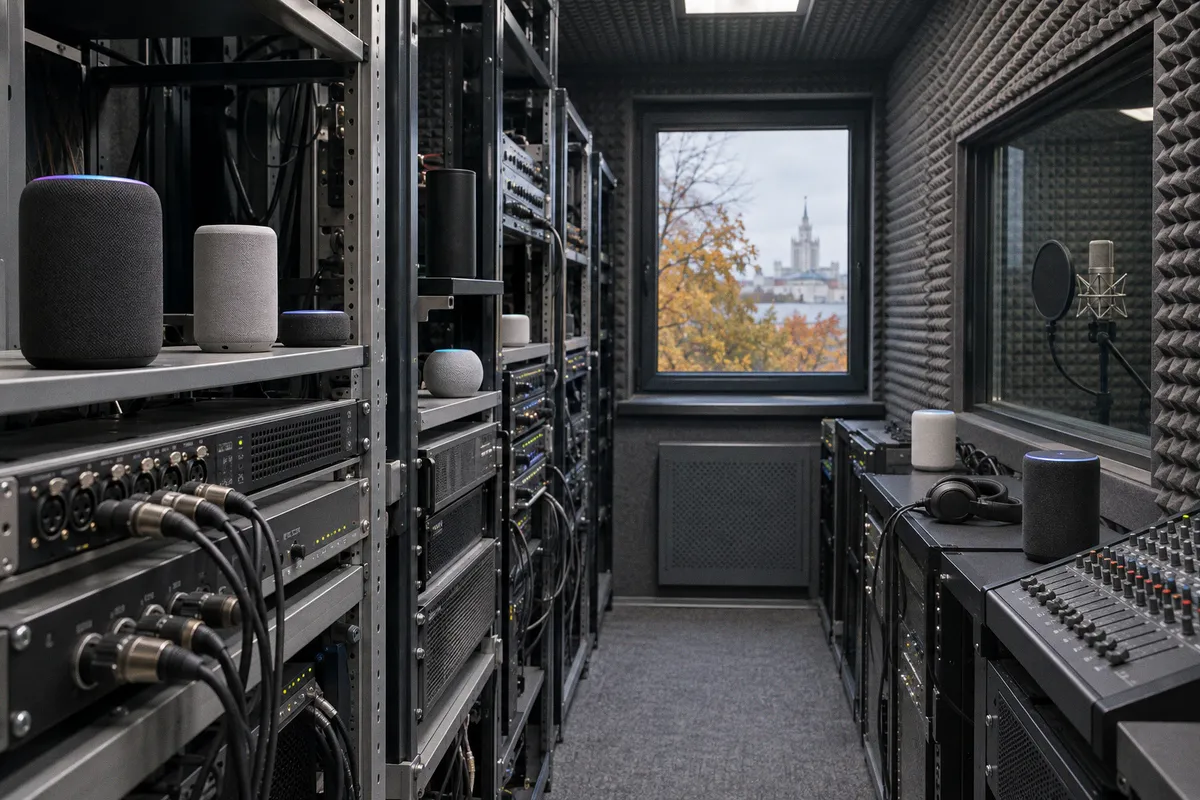
Поэтому вопрос, как часто колонка активируется ошибочно, нельзя свести к одной универсальной цифре.
В одном эксперименте с аудио из 12 телешоу исследователи зафиксировали в среднем 0,95 ложной активации в час. Это конкретный результат для определённых устройств, записей и условий воспроизведения. Он не описывает вероятность ошибки любой современной колонки в любой комнате. Для продуктовой оценки важны одновременно два показателя: как часто система просыпается без команды и как часто пропускает произнесённое ключевое слово.
Что именно считается ложной активацией
В типичном голосовом интерфейсе детектор ключевого слова работает как входная точка диалога. Он должен распознать заданную фразу, после чего устройство может перейти к следующему шагу: начать запись команды, передать её на распознавание речи или выполнить другую предусмотренную архитектурой операцию.
Ложная активация возникает, когда детектор принимает не произнесённое пользователем ключевое слово за команду к запуску. Источник ошибки может быть разным. В материалах Amazon, например, выделяются срабатывания, связанные с речью пользователя, и срабатывания из-за медиаконтента. К первой группе могут относиться фоновый разговор и шум, которые в сочетании создают акустический сигнал, похожий на ключевую фразу. Ко второй — запись слова или близкой к нему последовательности, воспроизводимая телевизором, радио или медиаплеером.
Это различие полезно для разбора логов. Если колонка активируется во время телепередачи, недостаточно записать инцидент как «помеху». Нужно установить, что именно происходило на входе: прозвучало ли точное ключевое слово, была ли похожая фонетическая последовательность, говорили ли одновременно несколько людей. Без такого разложения нельзя понять, какой участок флоу требует доработки: акустическая устойчивость детектора, набор обучающих примеров или поведение системы после активации.
При этом «активация» и «передача аудио» — не одно и то же событие. Что происходит после пробуждения, зависит от конкретной архитектуры устройства. Нельзя по одному факту случайного включения заключить, что запись обязательно ушла в облако, как нельзя утверждать и обратное. Для продуктовой диагностики это отдельные события, которые следует различать в телеметрии.
Ошибочная активация описывает решение детектора, а не весь дальнейший путь аудио в системе.
Такой подход особенно важен, когда ассистент оценивают по пользовательскому эффекту. Частое ложное пробуждение раздражает и снижает доверие к устройству. Но пропуск команды тоже ухудшает опыт: пользователь повторяет фразу, меняет формулировку или отказывается от голосового сценария. В логах эти случаи должны учитываться раздельно.
Откуда взялись 0,95 срабатывания в час
В эксперименте с аудио 12 телешоу, воспроизводившимся рядом с умными колонками в США и Великобритании, среднее значение составило 0,95 ложной активации в час. В пересчёте на речевой материал исследователи сообщили 1,43 срабатывания на 10 000 произнесённых слов. Для некоторых устройств не менее 10% эпизодов активации продолжались 10 секунд и дольше.
Эта статистика отвечает на ограниченный вопрос: как определённые устройства реагировали на конкретный медиаконтент в условиях данного теста. Она не задаёт частоту ошибок для квартиры с разговором на кухне, музыкой из телефона или включённым телевизором. На результат влияют модель колонки и её программная версия, акустические свойства комнаты, уровень и характер воспроизведения, язык и содержание аудио, а также правила, по которым исследователи засчитывают срабатывание.
У цифры есть и практическая сторона. Среднее значение на час полезно для сравнения сценариев внутри одного исследования, но оно скрывает распределение ошибок. Два устройства могут показать одинаковый средний показатель, хотя одно будет реагировать редко и неравномерно, а другое — чаще на определённый тип речи. Для команды, отвечающей за качество, важны не только число активаций, но и условия каждого инцидента: источник сигнала, длительность, последующее действие системы и возможность воспроизвести событие.
Исследование, опубликованное в 2020 году, включало 11 умных колонок от 8 производителей. Авторы описали сотни случайных активаций и опубликовали набор более чем из 350 проверенных триггеров. Это показывает, что проблема может быть связана с конкретными словами и звуковыми последовательностями, а не только с уровнем фонового шума.
Однако исторические результаты нельзя автоматически переносить на актуальные устройства. Меняются модели детекторов, прошивки и настройки порогов. Меняется и контент, который попадает в бытовую среду. Поэтому корректная формулировка звучит так: в определённом тесте получено такое значение. Формулировка «голосовой помощник в среднем ошибается почти раз в час» уже превращает результат конкретного сценария в неподтверждённое обобщение.
Что дают контролируемые испытания
В описанном в статье 2022 года эксперименте 11 колонок размещали примерно в одном метре от громкоговорителя. Испытания проводили в звукоизолированной камере, а предполагаемые срабатывания подтверждали повторными проверками. Такой дизайн помогает исследовать реакцию устройств на воспроизводимый материал: акустические условия можно удерживать стабильнее, а обнаруженный эпизод — перепроверить.
Для инженерной команды контроль среды решает задачу воспроизводимости. Если один и тот же фрагмент снова вызывает пробуждение, его можно включить в регрессионный набор и проверить, изменилось ли поведение после обновления детектора. Это особенно полезно для тестирования активации умных колонок в шумной комнате: сценарий должен описывать не просто «есть шум», а конкретный сигнал, дистанцию, тип помещения и критерий фиксации ошибки.
Но лабораторный тест не заменяет наблюдение за домашним использованием. Звукоизолированная камера убирает часть случайных переменных, тогда как в реальной комнате источники речи могут звучать одновременно, отражаться от поверхностей и меняться по громкости. Контролируемые условия повышают точность сравнения внутри эксперимента, но сами по себе не делают результат репрезентативным для всех домов.
Практичный набор испытаний поэтому строят слоями:
1. Чистая речь и тишина. Проверяют, распознаёт ли детектор ключевую фразу без акустических помех и не просыпается ли на нейтральных записях.
2. Фоновая речь. Добавляют разговоры и речевые фрагменты, в которых нет команды. Здесь оценивают, какие сочетания фонетики и фонового звука провоцируют ложное принятие.
3. Медиаконтент. Отдельно тестируют записи с точным ключевым словом и фразами, частично похожими на него. Этот сценарий нельзя смешивать с обычным шумом: у него другой источник риска.
4. Дальнее поле и реверберация. Проверяют, как меняется обнаружение, когда источник находится дальше или помещение заметно отражает звук. Такой тип тестовых клипов описан, в частности, в бенчмарке OpenWakeWord.
5. Повторная проверка инцидентов. Срабатывания подтверждают по записи и заданному критерию. Иначе в метрику могут попасть эпизоды, которые разные наблюдатели классифицируют по-разному.
Для каждого сценария стоит хранить не только итоговый процент или частоту, но и контекст: какой клип проигрывался, где находился источник, сколько длился тест, какое ключевое слово использовалось и что считалось активацией. При сравнении двух моделей это позволяет понять, за счёт чего изменилась метрика. Сопоставление бытовой акустики с характеристиками бесщеточного двигателя в инструменте здесь уместно только как напоминание о зависимости измерений от конструкции и условий работы: результат испытания всегда привязан к конкретной системе и сценарию, а не существует отдельно от них.
FAR и FRR: цена чувствительности
Для оценки детектора ключевого слова применяют две метрики. FAR, или частота ложного принятия, показывает, как часто система срабатывает, когда ключевое слово не произнесено. FRR, частота ложного отклонения, показывает, как часто детектор пропускает правильно произнесённую фразу.
Обе метрики зависят от порога принятия решения. Если сделать детектор чувствительнее, он может чаще реагировать на слабый или искажённый сигнал, но вместе с этим вырастает риск ложной активации. Если поднять порог, системе будет труднее принять случайное сходство за команду, зато часть корректных произнесений может остаться незамеченной.
Это компромисс для пользовательского пути. В сценарии, где человек часто говорит команду издалека или в движении, пропуск фразы может разрушить короткий флоу. В другом сценарии неприятнее регулярные пробуждения от телевизора. Подбор порога зависит от задачи, ожидаемой среды и того, что система делает после активации.
FAR и FRR нельзя читать как постоянные свойства устройства вне условий теста. Для сопоставления нужны порог детектора, тестовый набор, язык, акустическая среда и правила подсчёта. Если публикация сообщает только одну цифру, без этих параметров она мало говорит о том, как поведёт себя конкретная колонка в конкретной комнате.
Для продуктовой команды полезно смотреть на метрики вместе с последствиями. Ложное срабатывание, которое заканчивается коротким локальным событием, и активация, запускающая длинный диалоговый сценарий, по-разному влияют на опыт пользователя. Аналогично пропуск команды в разовом запросе и повторяющийся сбой в основном интенте имеют разную цену для retention. В телеметрии поэтому стоит связывать срабатывание с дальнейшими событиями флоу, не смешивая при этом факт активации с предположением о передаче аудио.
Похожие слова и пределы тестов
Отдельный класс испытаний посвящён фонетически похожим фразам. В исследовании FakeWake алгоритм за четыре часа создал 965 кандидатов для восьми англо- и китайскоязычных ассистентов. Авторы также сообщили, что после дообучения пяти экспериментальных детекторов те отвергали более 97% таких слов.
Это результат конкретной методики и экспериментальных моделей. Он показывает, что похожие на ключевую фразу последовательности можно искать системно, а затем использовать для проверки детектора. Но показатель не описывает все коммерческие ассистенты и не даёт оценки их качества в обычных домах. Для переноса результата потребовалось бы проверить те же модели, языки, тестовые данные и условия.
У тестирования есть ещё одно ограничение: наборы звука задают границы того, что система умеет выдерживать. Если в тесте есть чистая запись и белый шум, но нет телепередач, дальнего поля или реверберации, вывод о готовности устройства к бытовому использованию будет узким. Бенчмарки вроде OpenWakeWord включают клипы с шумом, дальним полем и реверберацией, а также оценивают полноту обнаружения и ложные срабатывания в час. Это полезная основа для сравнения, но не замена проверки на целевых сценариях продукта.
При разборе результатов следует разделять три вопроса:
- На каком звуке детектор активировался: на точном ключевом слове, фонетически похожей фразе, фоновой речи или сочетании речи и шума?
- В каких условиях это произошло: при близком или дальнем источнике, в записи с реверберацией, на телевизионном контенте?
- Как система повела себя после активации: какой следующий шаг диалога запустился и завершился ли он корректно?
Такое разложение превращает общую метрику в задачи для команды. Один тип ошибок может потребовать расширения тестового корпуса, другой — пересмотра порога, третий — изменения дальнейшего флоу. Без классификации логов все случаи выглядят одинаково, а средняя частота скрывает первопричину.
Как читать статистику без ложной точности
Данные исследований подтверждают, что фоновые разговоры и медиаконтент способны вызывать случайные активации. Они также показывают, что результаты зависят от устройства, материала и методики. Универсальной частоты ложных срабатываний для всех ассистентов и бытовых условий имеющиеся результаты не задают.
Поэтому значение 0,95 в час следует воспринимать как результат конкретного эксперимента с аудио 12 телешоу, а не как прогноз поведения любой колонки. Испытание 11 устройств примерно в метре от источника в контролируемой среде отвечает на иной вопрос, чем наблюдение в жилой комнате. А показатели FAR и FRR имеют смысл только вместе с порогом, набором тестов и условиями измерения.
Для пользователя важен итоговый опыт: насколько часто устройство просыпается без команды и насколько надёжно принимает команду, когда она произнесена. Для разработчика к этим двум метрикам добавляются воспроизводимость и разбор причин. Именно они позволяют понять, что менять в детекторе и где проходит граница между чувствительностью и устойчивостью.